וואו בדיוקווקוקוקוקקקקקק
https://go.chatlytics.ai/r/hxMmqIp
Sloptimist (@SloptimistPrime) on XWhat I learned from setting up a DGX Spark cluster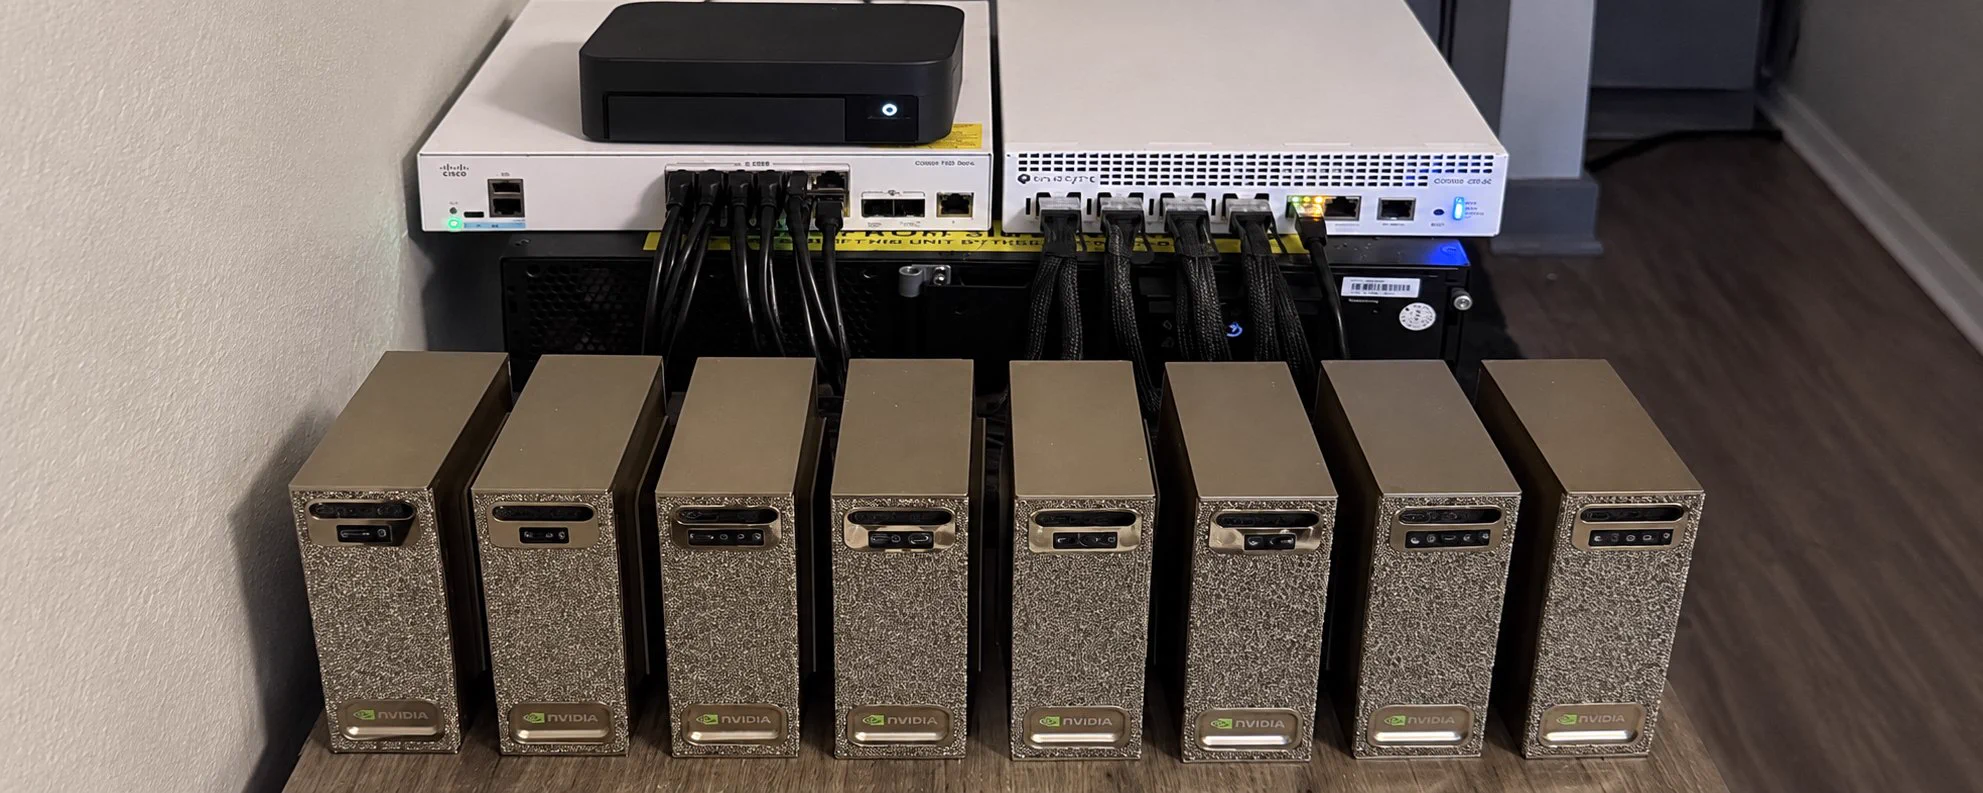
וואו בדיוקווקוקוקוקקקקקק
זה שלך?
לא אבל זה הצחיק אותי ממש
יודע של מי?
https://go.chatlytics.ai/r/IeGZy6n
Dan Hockenmaier (@danhockenmaier) on XDan Hockenmaier (@danhockenmaier) on X
https://go.chatlytics.ai/r/2DC2cjG
PrismML (@PrismML) on XToday, we’re announcing Ternary Bonsai 2 27B. Based on Qwen3.8 27B, Bonsai 2 27B is 9x smaller than its full-precision counterpart while re
@107684007252205
סכם לנו בבקשה
בקצרה: PrismML הכריזו על Ternary Bonsai 2 27B — מודל שמבוסס על Qwen3.8 27B, עם דגש על הקטנת הגודל בלי לאבד הרבה איכות.
• 27 מיליארד פרמטרים, בנפח 5.9GB — לטענתם, קטן פי 9 מהגרסה בדיוק מלא.
• שומר על 98.2% מהביצועים המשוקללים בבנצ׳מרקים של מודל המקור. זה לא אומר 98.2% הצלחה בכל משימה.
• לעומת הדור הקודם, הגודל נשאר זהה והשיפור הוא באיכות — במיוחד בקוד עם סוכנים, הסקה מולטימודלית ושימוש בכלים לאורך משימות ממושכות.
• זמין ברישיון Apache 2.0, שמאפשר גם שימוש מסחרי בכפוף לתנאיו.
למה זה מעניין? זה עשוי לאפשר להריץ מודל גדול יחסית מקומית, עם דרישות זיכרון נמוכות יותר — רלוונטי לסוכנים מקומיים ולפרטיות.
הכוכבית: אלה נתוני החברה, לא בדיקה עצמאית. 5.9GB הוא נפח המודל, לא בהכרח כל הזיכרון שצריך בזמן הרצה, ו״קטן פי 9״ לא אומר ״מהיר פי 9״. הפוסט לא מפרט חומרה, מהירות בפועל או את הבנצ׳מרקים.
לאו דווקא בסדר הזה. הייתי מחליף את 4.7 ו-5, אבל מדויק.
כמה שניסיתי לגרום לו לעבוד, אז Strix Halo בינתיים לא ממש תומכים ב-ROCm. זה קצת מבאס כי רציתי ממש לשחק איתו.
השקעתי איזה שעה וחצי בניסיון לגרום לו לעבוד, אבל הוא לא עבד כל כך טוב. בינתיים יש להם מלא באגים.
אני לא מדבר על המודל, אני מדבר על התשתית שמשחררים.
בסוף AMD יגיעו לשם
לרוב קוונטיזציה טרינרית שוברת ביצועי מודלים..
אם הם באמת מצליחים בשיטה הזו, זה מעניין על מודלים יותר גדולים מ 27B
לא רק בגלל הגודל, גם המהירות.. כפל מטריצות מתייתר ויש חיבור/חיסור
הבעיה בסוף לא קשורה ל-AMD. הם צריכים בעצם לבנות את ה-implementation שלהם של המודלים.
אני לא יודע אם אני מחדש לך, אבל אגיד את זה בכל מקרה לטובת מי שלא מכיר: כש-vendor משחרר מודל, הוא משחרר גם את המשקולות וגם את הקוד שדרוש כדי להריץ אותו. הקוד הזה צריך להתאים ל-providers הקיימים: ROCm, CUDA, Vulkan, וגם MLX כמובן.
בגדול הם שחררו קוד עבור CUDA ועבור Vulkan (לא בטוח לגבי MLX). לגבי ROCm, הם שחררו אבל עשו עבודה סופר מרושלת: הוא לא קורא את המשקולות כמו שצריך, אז הוא אמנם רץ אבל פולט כמויות של ג'יבריש בתור תשובות (ג'יבריש מאוד מהיר, אגב). אז זה לא תלוי ב-AMD, אלא פשוט בזה שה-vendor של המודל צריך לתקן את הקוד, ובינתיים הם לא תיקנו את הבעיות ב-ROCm.
הסיבה לא להשתמש ב-Vulkan במקרה של Strix Halo היא שה-prefill שלו איטי להחריד, יותר איטי מסבתא שחוצה מעבר חצייה. אי אפשר לעבוד איתו. לעומת זאת, ה-prefill ב-ROCm ממש סבבה, וגם הביצועים נראים טוב במודלים אחרים.
בינתיים המודל שהכי אהבתי לעבוד איתו, שנתן ביצועים ותוצאות טובות, היה Ornyth. אני ממש מחכה שמישהו יוציא משהו נורמלי כזה כמו החבר'ה האלה.